

¿Qué pasó ayer? En un minuto:
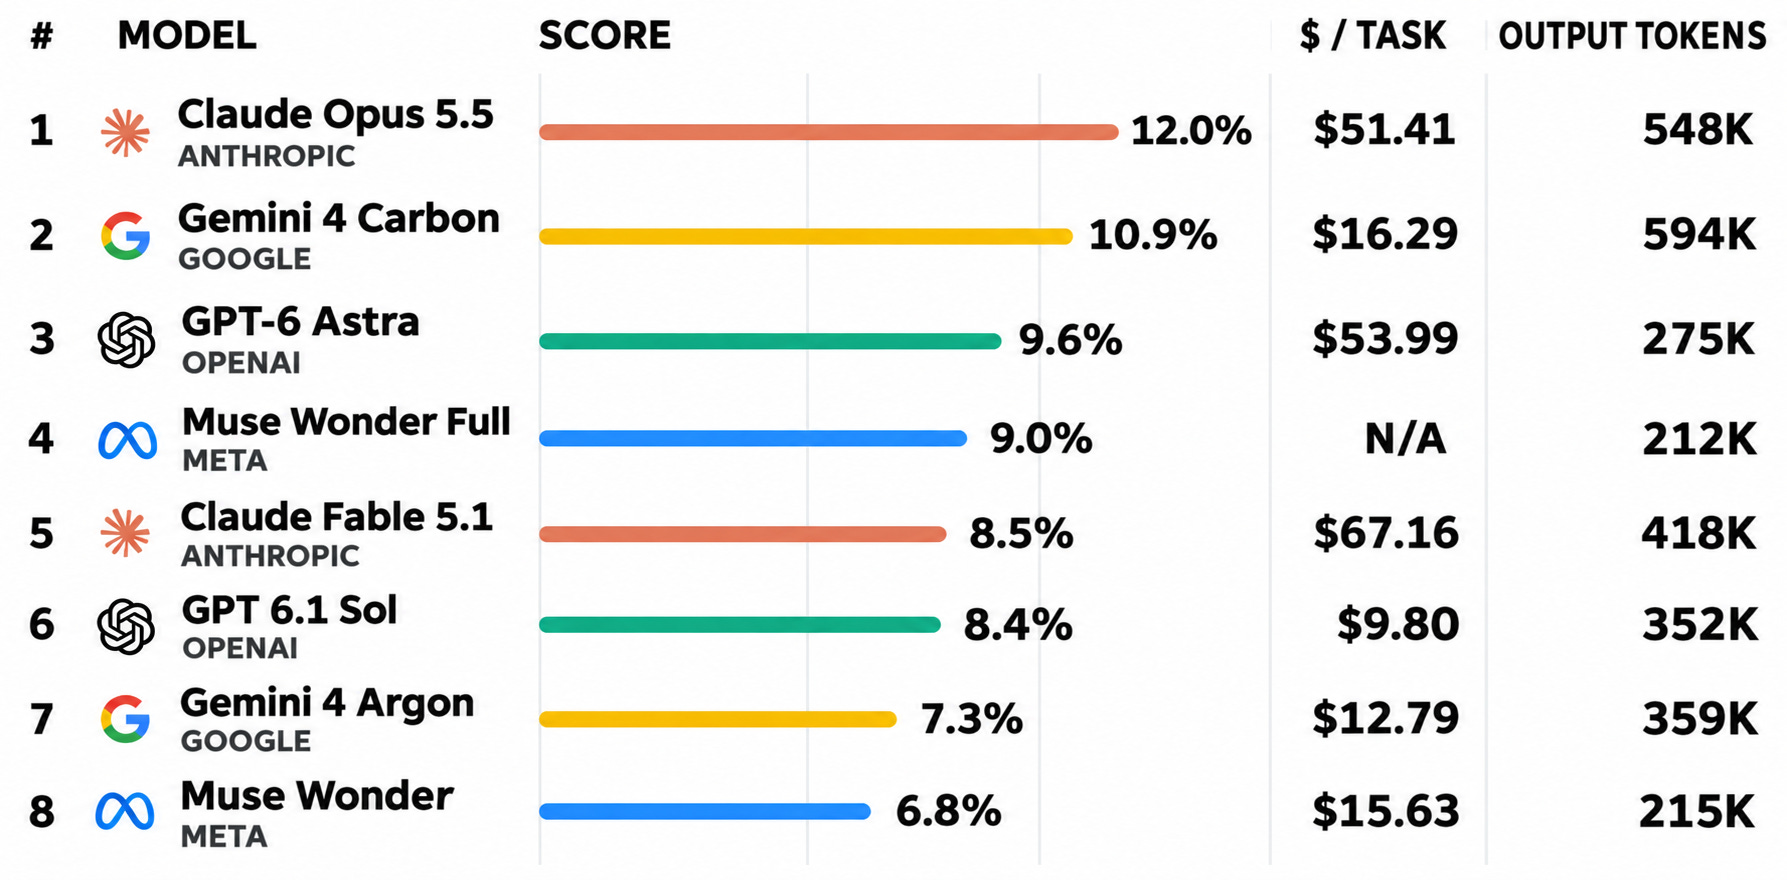
SemiAnalysis lanza GDPx, un benchmark de 206 tareas en 11 dominios de alto valor donde todos los modelos puntúan bajo, con Claude Opus 5.5 al frente.
El S-1 enmendado de Anthropic revela ingresos trimestrales de 16.960 millones de dólares junto a una pérdida operativa de 567 millones en el último trimestre.
OpenAI presenta LifeVal, un benchmark de tareas cotidianas sin validación externa en el que GPT-6 Astra alcanza un 80,6% frente al 49,3% de GPT-5.2.
Investigadores muestran cómo GPT-6 Astra mejora un modelo abierto editando directamente sus pesos; eleva su rendimiento en MATH-500 del 7,9% al 48,1%.
OpenAI se alía con Cathedral Systems para atacar sus propias defensas con IA en un sprint de seguridad con subidas en las recompensas por encontrar fallos.
Hume AI ofrece un modelo para análisis de audio que detecta emociones e ironía con más precisión allí donde modelos basados en transcripción fallan.
Waymo y Toyota probarán desde 2027 en Japón una flota de robotaxis con el hardware autónomo integrado en la propia línea de producción.
OpenAI ficha a Dan Driscoll, exsecretario del Ejército de Estados Unidos, para asesorar sobre seguridad nacional.
Gracias por leer 1 Minuto de IA. Si te ha gustado esta edición, no te olvides de dar al ♡ para apoyar este proyecto.
Y si tienes más de un minuto…
1. SemiAnalysis mide a los agentes en trabajo experto
SemiAnalysis ha publicado GDPx, un benchmark que somete a agentes de IA a 206 tareas exigentes repartidas en 11 dominios: diseño de chips, ciberseguridad, biología, finanzas, derecho, trading cuantitativo, automejora recursiva, diseño de hardware, ciencia de materiales, alineamiento e ingeniería de software. La selección es deliberada. La firma deja fuera la administración pública, el inmobiliario o los seguros porque cree que el primer billón de dólares de ingresos de la IA se concentrará en sectores donde la inteligencia de frontera rinda un alto retorno, no repartido por toda la economía. Por eso descarta construir la prueba a partir del peso en el PIB o de taxonomías ocupacionales.
Las puntuaciones son bajas para todos, algo positivo para el sector, porque el margen de mejora es precisamente lo que da valor a la prueba en un momento en que varias referencias de uso común están cerca del techo. Claude Opus 5.5, de Anthropic, lidera con un 12% de media, y Gemini 4 Carbon, de Google, le sigue con un 10,9%. GPT-6 Astra, de OpenAI, encabeza las tareas de investigación en IA y de ciencia de materiales. Hay una salvedad metodológica que altera la clasificación: los clasificadores de seguridad de Opus 5.5 y GPT-6 Astra se activan a veces en ciberseguridad, biología y alineamiento, lo que rebaja sus resultados. SemiAnalysis publica también una tabla que excluye esos tres dominios, en la que OpenAI y Anthropic dominan la parte alta.
Ve en GDPx un sucesor útil de GDPval, aunque a 𝕏 @emollick (Ethan Mollick) le falta lo esencial de aquel: referencias humanas con las que comparar.
Las notas bajas explican, para 𝕏 @tunguz (Bojan Tunguz), por qué la IA todavía rinde poco en retorno de inversión, una brecha que espera ver cerrada pronto.
El interés de 𝕏 @sundarpichai (Sundar Pichai) se dirige al coste: celebra que haya un benchmark con recorrido y destaca lo barato que resulta Carbon frente a sus rivales.
Desde Google DeepMind, 𝕏 @demishassabis (Demis Hassabis) recibe la prueba como una incorporación bienvenida al escaso repertorio de evaluaciones rigurosas.
Lo llamativo para 𝕏 @kimmonismus (Chubby) es que el ganador lo sea con una nota tan baja y por un margen tan estrecho sobre el segundo.
Más información:
📎 GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains
2. El nuevo S-1 de Anthropic: más ingresos, pérdidas y aviso de RSI
Anthropic ha registrado ante la SEC una versión enmendada de su folleto de salida a bolsa con resultados del tercer trimestre por primera vez. Ingresó 16.960 millones de dólares, un 1.127% más que un año antes, y suma 33.200 millones en nueve meses. El crecimiento convive con un giro en márgenes: pasó de un beneficio operativo de 974 millones en el segundo trimestre a una pérdida operativa de 567 millones en el tercero. Las pérdidas acumuladas en nueve meses alcanzan los 104.000 millones. El peso del cómputo explica buena parte del cuadro. Los compromisos de infraestructura ascienden a 895.400 millones, más otros 175.000 millones todavía sin precio, unas 32 veces sus ingresos.
Antes de 2031 vencen 447.500 millones, con Broadcom (161.000 millones en arrendamientos), Google (121.000), SpaceX (hasta 120.000) y Amazon (110.000) como principales contrapartes. El cambio más comentado está en la página 29: las estimaciones internas indican que modelos futuros podrían alcanzar de forma inminente el umbral de progreso drásticamente acelerado por la propia IA, definido como lograr en un año el avance de dos respecto a la base 2018-2024. La salida a bolsa apunta a una valoración de unos 1,5 billones, tras el peor mes del Nasdaq en más de 18 meses.
Para 𝕏 @WesRoth (Wes Roth), que modelos cada vez más capaces ayuden a construir a sus sucesores pesa mucho más que cualquier nuevo salto en un benchmark.
El giro a pérdidas lo atribuye 𝕏 @rohanpaul_ai (Rohan Paul) sobre todo a unos 5.000 millones en cómputo a corto plazo, mucho más caro que el contratado a largo plazo.
La lectura de 𝕏 @kimmonismus (Chubby) es que el sector no muestra señales de frenar, y presenta el aviso como prueba de que la aceleración continúa.
Más información:
📎 AMENDMENT NO. 1 TOFORM S-1 REGISTRATION STATEMENT
3. OpenAI mide la IA en tareas cotidianas con LifeVal
OpenAI ha presentado LifeVal, un benchmark que evalúa si los modelos de IA resuelven encargos de la vida diaria en lugar de problemas habituales de razonamiento abstracto o de programación. Para diseñarlo combinó datos sobre cómo reparte la gente su tiempo, una encuesta a casi 4000 personas y el feedback de miles de usuarios de ChatGPT sobre dónde querrían más ayuda de un asistente personal. Las tareas cubren cuidado infantil, finanzas personales, compras, salud y trámites con la administración. Algunos ejemplos: matricular a un niño en la guardería tras una mudanza, pedir comida halal con un presupuesto ajustado, planificar menús para un familiar con diabetes o reservar la inspección del coche antes de un viaje.
La compañía presenta la prueba como parte de su idea de que la AGI debe servir a cada persona en lo que más le importa. El lanzamiento tiene también una lectura competitiva: OpenAI diseña la métrica, elige las tareas y publica los resultados de sus propios modelos, sin validación externa por ahora. El terreno elegido, el de los agentes personales, es donde varias compañías intentan ahora convertir capacidad técnica en uso diario. Según los datos de OpenAI, GPT-6 Astra alcanza un 80,6%, frente al 49,3% de GPT-5.2, una mejora conseguida en menos de un año.
El planteamiento de 𝕏 @OpenAI (Openai) vincula directamente el benchmark con su misión: una AGI que beneficie a toda la humanidad debe empezar por ayudar en las tareas que cada usuario considera prioritarias.
Lo interesante para 𝕏 @VaibhavSisinty (Vaibhav Sisinty) es el cambio en lo que cuenta como progreso: calificar a la IA por la vida real y no por exámenes.
La selección de tareas le resulta llamativa a 𝕏 @zhodonx (Zhod), que la describe como el tipo de encargos dispersos y prosaicos que ocupan el día a día de cualquiera.
Con cierta ironía, 𝕏 @0xJokker (Jokker) califica de jugada típica de OpenAI construir la prueba a partir del feedback de sus propios usuarios de ChatGPT.
Más información:
📎 LifeVal: Measuring AI progress on the tasks that matter in everyday life
4. Un LLM corrige otro modelo editando sus pesos
Investigadores vinculados al MIT, en un blog firmado por Rikiya Takehi, presentan el concepto de “Programación en el Espacio de los Pesos” (Weight-Space Programming): modelos de frontera que interpretan y modifican directamente pesos de otras redes neuronales, sin entrenamiento por gradiente ni bucles de entrenamiento. El caso más llamativo lo protagoniza GPT-6 Astra. Encargado de mejorar en matemáticas a Qwen3.5-0.8B, un modelo abierto más pequeño. Detectó en sus pesos un fallo que provocaba bucles de razonamiento, ya advertido en la ficha técnica del propio modelo, y lo corrigió modificando el 0,016% de los pesos en dos capas. Con la misma configuración de muestreo, MATH-500 pasó del 7,9% al 48,1% y la mejora se trasladó al seguimiento de instrucciones, donde IFEval se triplicó.
El resultado es interesante pero algo exagerado para 𝕏 @giffmana (Lucas Beyer (Bl16)): el prompt apuntaba claramente a los bucles como problema y, según los propios autores, el modelo no logró mejorar las matemáticas por otras vías.
La cautela de 𝕏 @emollick (Ethan Mollick) resume bien el momento: lo considera un avance importante, pero condiciona su valoración a que se replique.
Esa replicación ya existe para 𝕏 @tunguz (Bojan Tunguz), que enlaza una reproducción independiente de los resultados.
La analogía con la plasticidad neuronal es la lectura de 𝕏 @javilopen (Javi Lopez), que admite que los mecanismos son muy distintos pero ve en esta capacidad una condición previa para escenarios más preocupantes.
Más información:
📎 Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights
📎 Weight-Space Programming from scratch on simple tasks
5. OpenAI recurre a Cathedral para atacar sus propias defensas
OpenAI prepara su próximo sprint interno de seguridad junto a Cathedral Systems, una startup de ciberseguridad con IA fundada por antiguos miembros del DOGE, el departamento de eficiencia gubernamental impulsado desde la Casa Blanca. Los investigadores de Cathedral usarán los modelos de OpenAI junto a los equipos internos para poner a prueba sus defensas y localizar debilidades en sus plataformas. La compañía lo justifica con un argumento sencillo: si la IA es cada vez mejor encontrando vulnerabilidades, los defensores deben usarla antes que los atacantes.
Cathedral cerró a principios de año una ronda fundacional coliderada por Andreessen Horowitz, cuyo cofundador ha amplificado el anuncio. El acuerdo llega acompañado de una subida notable de las recompensas del programa de bug bounty de OpenAI, con premios que algunos usuarios sitúan en hasta 172.000 dólares. Es el segundo sprint en poco tiempo, tras otro dedicado a corregir errores de ChatGPT, y encaja con una práctica que se extiende en el sector: usar IA ofensiva para endurecer la infraestructura propia.
El planteamiento de 𝕏 @OpenAI (Openai) convierte la seguridad en una carrera de velocidad: la capacidad de la IA para encontrar fallos obliga a ponerla al servicio de la defensa antes de que la aprovechen otros.
El origen del socio es lo que subraya 𝕏 @MTSlive (Mts), que presenta el acuerdo poniendo por delante el vínculo de Cathedral con antiguos miembros del DOGE.
Con ironía, 𝕏 @AnikaCodes (Anika) describe la jugada como colgar un cartel de recompensa en la puerta y entregar ganzúas a Cathedral para revisar cada ventana.
Para 𝕏 @Brainrot_Labs (Brainrot Labs), el movimiento de fondo no es la alianza sino el aumento de las recompensas por fallos críticos, que considera la pieza de más peso.
Más información:
📎 openai.com: Preparing our next security sprint to harden OpenAI
📎 openai.com: Rewarding defenders with bigger bug bounties
6. Hume lanza una API que escucha el audio
Hume AI, la empresa especializada en voz y ciencia emocional, ha presentado la Hume Audio Decision API, un modelo que responde preguntas sobre una grabación analizando el sonido directamente, sin transcribirlo antes. El desarrollador redacta sus propias preguntas y opciones de respuesta (sí o no, opción múltiple, escala o marcas de tiempo), del tipo «¿cuántos hablantes hay?» o «¿el cliente suena frustrado?», y recibe probabilidades sobre cómo lo interpretarían oyentes humanos. Hume asegura que una sola llamada sustituye a más de diez modelos.
El problema que ataca es conocido: un agente de voz puede superar todas las pruebas de transcripción y aun así gestionar mal la conversación, porque los sistemas que trabajan solo con texto pierden suspiros, pausas o ironía. Según la compañía, el modelo se entrenó con más de 10 millones de juicios humanos y coincide con un panel de evaluadores el 70,7% de las veces. El producto se orienta a evaluar agentes de voz, puntuar la naturalidad de modelos entre versiones y detectar casos para escalado o reentrenamiento, y la empresa afirma trabajar con cinco de los siete laboratorios líderes.
El argumento de venta de 𝕏 @hume_ai (Hume Ai) es la consolidación: lo que antes exigía una batería de modelos especializados queda reducido a una única llamada, en tiempo real o sobre horas de grabación.
Lo ve como un paso importante para la escucha automática 𝕏 @rohanpaul_ai (Rohan Paul), porque el desajuste entre lo que se dice y cómo se dice es justo lo que ningún flujo basado en texto puede detectar.
El caso que plantea 𝕏 @bernirov (Berni) es el del panel de control que sigue en verde mientras un cliente ironiza, un fallo que el análisis de sentimiento sobre transcripciones deja pasar.
La industria lleva tiempo construyendo bocas para la IA y Hume ha fabricado los oídos, resume 𝕏 @slash1sol (Slash1S), que ve un hueco desatendido frente al avance de la síntesis de voz.
Más información:
📎 Decision Model API
7. Waymo convertirá el Toyota bZ4X en robotaxi para Japón
Waymo, la filial de conducción autónoma de Alphabet, ha ampliado su alianza con Toyota para empezar en 2027 las pruebas operativas y de validación de una flota autónoma de Toyota bZ4X en Japón. El SUV eléctrico se fabricará en la planta de Takaoka, en Aichi, y el hardware de Waymo se instalará allí mismo, integrado en las líneas de producción de Toyota y no mediante adaptaciones posteriores a la salida de fábrica. Esa diferencia es importante, ya que montar sensores y cómputo en la cadena del fabricante abarata y homogeneiza cada unidad frente al modelo de reconversión que ha usado Waymo hasta ahora.
El acuerdo podría abrir el primer servicio de transporte autónomo bajo demanda de Japón y prevé llevar después el vehículo al Reino Unido y a otros mercados de Waymo. El bZ4X aporta una plataforma eléctrica de mercado masivo a una flota que ya combina Jaguar, furgonetas Zeekr y Hyundai IONIQ 5, aunque sumar modelos no resuelve por sí solo la rentabilidad por vehículo. El marco regulatorio japonés también se mueve: según Nikkei, el Ministerio de Transporte (MLIT) prevé revisar sus normas para certificar desde diciembre vehículos autónomos sin volante ni pedales, una puerta que beneficiaría a diseños como el Cybercab de Tesla.
La presentación de 𝕏 @Waymo (Waymo) pone el acento en la experiencia del pasajero: el render del bZ4X personalizado busca transmitir comodidad y accesibilidad antes que capacidad técnica.
El escepticismo lo aporta 𝕏 @herbertong (Herbert Ong), que recoge la advertencia de que la escala no lo resuelve todo y de que las cuentas deben salir desde la primera unidad, no confiando en el volumen.
Lo que más llama la atención a 𝕏 @niccruzpatane (Nic Cruz Patane) es la cantidad de sensores visibles en el vehículo, que comenta con humor.
La lectura de 𝕏 @jonaslamis (Jonas) es que el próximo robotaxi de Waymo es un Toyota, con el Jaguar I-Pace como referencia que este modelo viene a relevar.
8. OpenAI ficha al exsecretario del Ejército Dan Driscoll
OpenAI ha incorporado a Dan Driscoll, exsecretario del Ejército de Estados Unidos y especialista en drones. Según la compañía, Driscoll asesorará sobre cómo la IA avanzada puede reforzar la seguridad nacional y la ciberseguridad, con atención especial al trabajo con aliados de Estados Unidos, y ayudará a extender la adopción de la IA en instituciones de defensa estadounidenses y aliadas. Veterano de la guerra de Irak, dejó el cargo en septiembre tras tensiones con el secretario de Defensa, Pete Hegseth, aunque mantiene una relación cercana con el vicepresidente JD Vance.
El fichaje coincide con la expansión del uso de IA en el Pentágono y con una implicación creciente de OpenAI en el ámbito militar. Para los laboratorios de frontera, los contratos de defensa se han convertido en un mercado disputado, y los perfiles con experiencia castrense y acceso político pesan tanto como la tecnología a la hora de negociar con gobiernos. Driscoll no es un caso aislado, es el último de varios exfuncionarios de la Administración Trump que han pasado a OpenAI, y llega apenas dos meses después de haber dirigido el Ejército.
Lo que subraya 𝕏 @ScottMStedman (Scott Stedman) es la velocidad de la puerta giratoria: hace dos meses Driscoll dirigía el Ejército y ahora trabaja para OpenAI.
El mapa de lealtades es la clave para 𝕏 @AndrewCurran_ (Andrew Curran), que resume la posición de Driscoll en Washington: enfrentado con Hegseth, pero amigo de Vance.
El foco de 𝕏 @rohanpaul_ai (Rohan Paul) está en el alcance del cargo, que no se limita al Pentágono: Driscoll asesorará también a empresas, sobre todo entre aliados de Estados Unidos.
Para 𝕏 @GeneralMCNews (The General), el nombramiento es una pieza más de la expansión de OpenAI hacia el trabajo directo con el ejército y el Pentágono.
Más información:
📎 openai.com: Dan driscoll joins OpenAI